프로젝트/06
전역 준비 콘텐츠 엔진
검색에서 진단까지 이어지는 유입 구조
서비스를 만든 다음에야 사용자가 오지 않는다는 문제가 남았습니다.
한 줄
전역 준비 검색어로 들어온 방문자를 글 하단 한 곳의 CTA로 진단 봇까지 보내고, 어느 글에서 왔는지를 딥링크로 되짚는 구조입니다. 원고 검증부터 네이버 붙여넣기용 변환까지는 스크립트가 처리합니다.
문제
기관 도입을 기다리는 동안 서비스는 아무도 쓰지 않습니다. 유료화도 기관 채택도 정지된 상태에서 사용자를 만들 수 있는 경로는 검색뿐이었습니다.
채널은 네이버 블로그 단독으로 정했습니다. 타깃이 40~50대 예비역 간부인데 이 연령대의 정보 탐색은 여전히 네이버에서 일어납니다. 자체 도메인은 SEO 축적에 1년이 걸려, 검증 후 12개월 뒤 재검토하기로 했습니다.
그런데 막상 쓰기 시작하니 병목은 글이 아니라 발행이었습니다. 마크다운 원고를 네이버 스마트에디터에 붙이면 서식이 깨지고 딥링크 CTA가 죽습니다. 매번 손으로 고치면 주 1편 속도가 나오지 않습니다.
내가 한 일
콘텐츠 20편 기획. 정책·제도 8편(군인연금, 전직지원금, 국방전직교육원, 제대군인지원센터, 호봉인정, 건강보험, 내일배움카드, 취업지원), 자격증·직무 5편, 경험·사례 5편, 축이 되는 장문 글 2편입니다. 2026년 8월 30일 첫 글을 올렸고, 9월 중순 기준 6편을 발행했습니다.
발행 자동화 스크립트 4종. 손이 많이 가면서 실수가 잦은 지점만 골라 자동화했습니다.
- 출처 표기 형식 점검 — 규칙에 맞지 않는 인용을 잡아냅니다. 형식만 보고 사실관계는 보지 않습니다
- 네이버 붙여넣기용 HTML 변환 — 스마트에디터 서식 깨짐과 링크 손실을 없앱니다
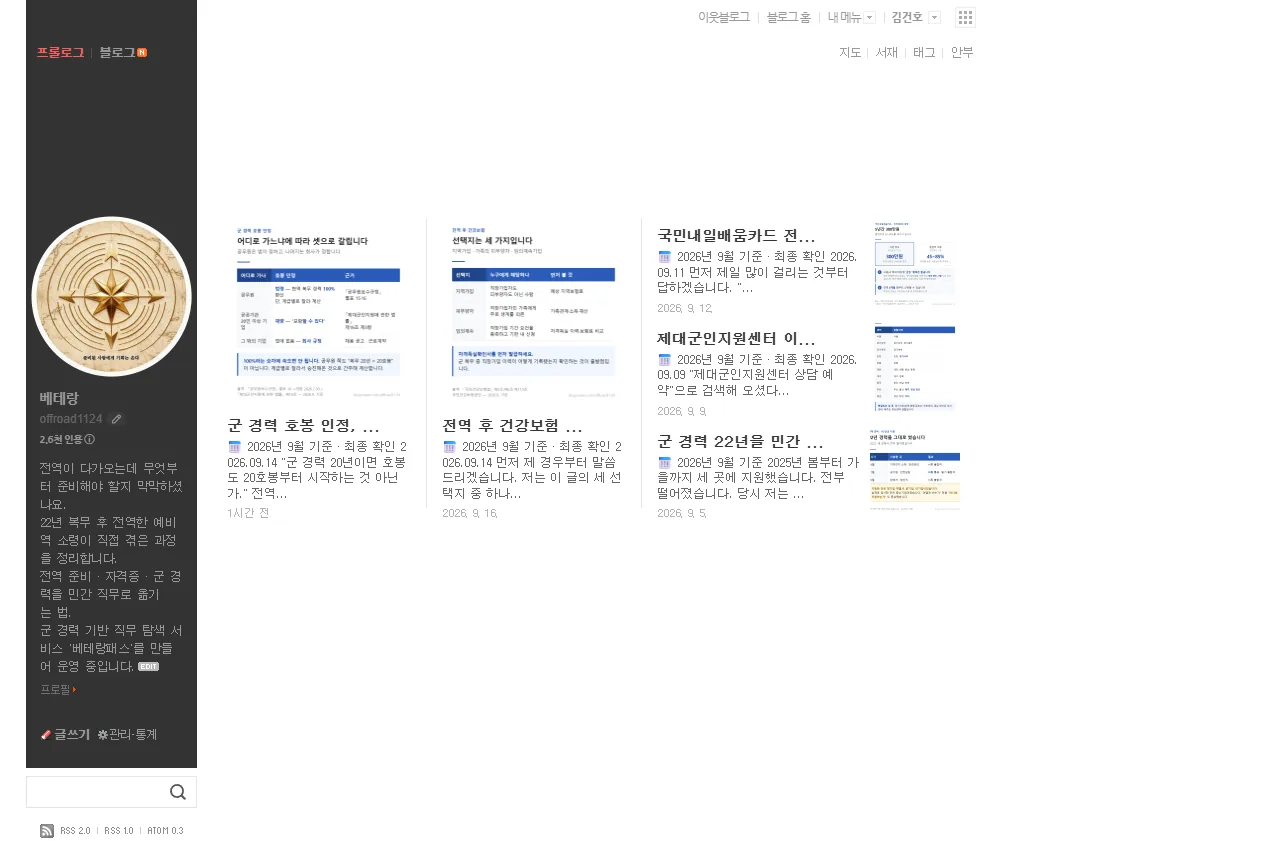
- 인포그래픽 요약 카드 PNG 생성 — 헤드리스 브라우저로 800px 폭을 2배로 구워 1600px로 냅니다. 맨 위 카드가 네이버 썸네일이 됩니다
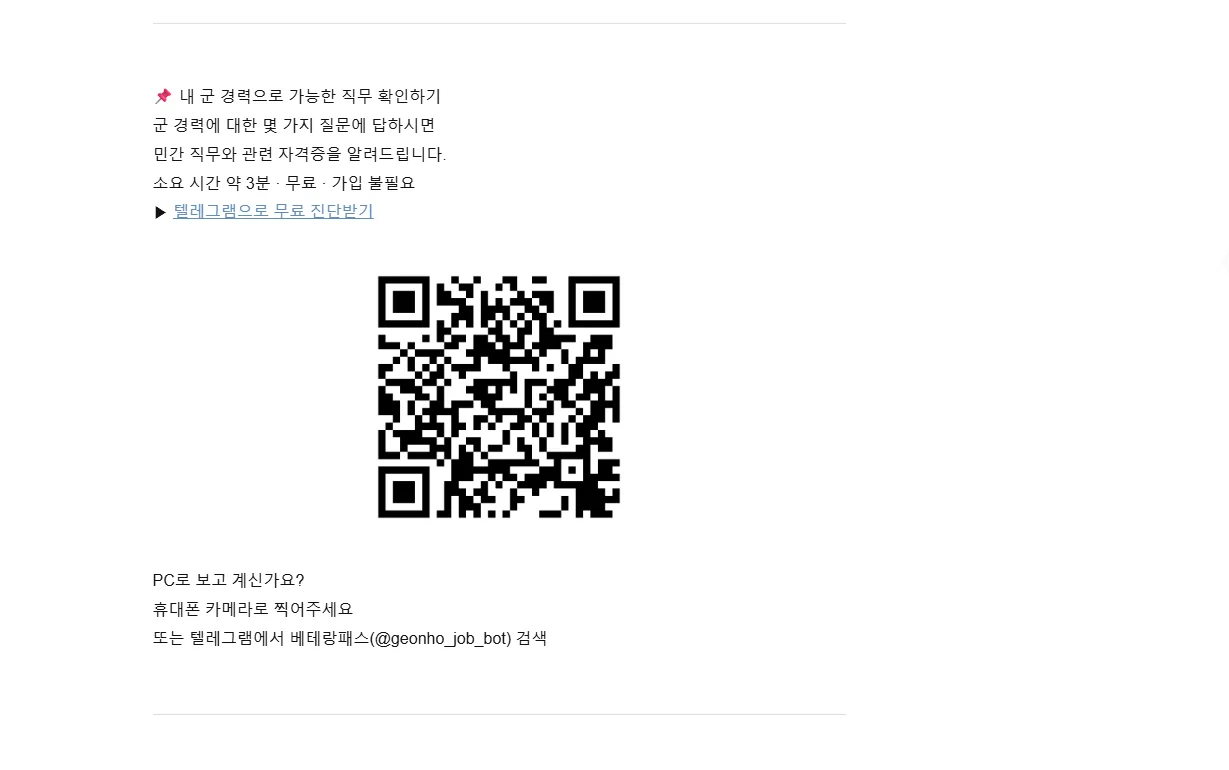
- QR 코드 생성 — 정적 QR을 600px 이상으로 만듭니다. 네이버 이미지 압축을 견디게 하기 위해서입니다
자동화하지 않은 것도 정했습니다. 정책 수치·자격·기한 확인은 반드시 사람이 공식 사이트에서 채웁니다. 기관 발간 PDF를 근거로 쓸 때는 면수까지 인라인 출처로 답니다. 카드 이미지와 QR을 본문 어디에 넣을지도 사람이 판단합니다.
키워드 선정 기준. 실행 유도형 키워드(신청·절차·확인)만 다룹니다. 판별에는 검색량 평균이 아니라 최고일 지수 ÷ 평시 지수 비율을 씁니다. 비율이 크면 스파이크성, 작으면 실수요입니다.
CTA와 계측. CTA는 글 하단 한 곳, 링크 → QR → 텍스트 검색 안내의 3중 구조입니다. 딥링크 파라미터는 글 슬러그 뒤에 _l(링크), _q(QR), _d(대시보드 재진입)를 붙여 유입 경로를 구분합니다. 봇의 표시 이름을 '베테랑패스'로 맞춰 텍스트 검색 경로가 실제로 작동하게 했습니다.
설계 판단
인포그래픽 수치 대조를 자동화한 이유. 카드 이미지의 숫자와 본문 숫자가 어긋나는 사고가 가장 위험합니다. 본문은 고쳐도 이미지를 다시 만들지 않으면 그대로 남고, 읽는 사람은 이미지를 먼저 봅니다. 그래서 대조 옵션을 스크립트에 넣어 발행 전에 걸리게 했습니다.
원고 순서는 번호순이 아니라 출처 준비순입니다. 세 번째 글로 예정했던 국방전직교육원 편은 기관 사이트가 스크립트 렌더링이라 읽히지 않고 공개 데이터는 2022년판이라, 지금 쓰면 금액·기한이 거의 전부 '확인 필요'로 남습니다. 공식 PDF가 이미 확보된 제대군인지원센터·내일배움카드 편을 먼저 썼습니다. 근거 없는 글을 순서 때문에 내지는 않습니다.
경험담은 AI에게 쓰게 하지 않습니다. 경험·사례 글은 AI가 질문하고 제가 답한 내용만 사용합니다. 이 카테고리가 다른 블로그와 갈리는 지점인데, 여기에 생성된 문장을 섞으면 전체 신뢰가 무너집니다. 경험담 안에서 금액·자격·기한을 한 줄이라도 언급하면 그 문장에는 출처를 답니다.
수익화를 KPI에서 뺐습니다. 애드포스트는 붙이되 목표로 삼지 않습니다. 수익을 지표로 두면 주제 선정이 조회수 쪽으로 오염되고, 진단 전환이라는 원래 목적에서 멀어집니다. 제휴·광고 링크도 넣지 않습니다. 정부 제도 글의 중립성이 사라지면 나머지 선택지도 같이 죽습니다.
공개 범위를 먼저 정했습니다. 부대명, 작전, 특정 가능한 인물은 쓰지 않습니다. 현재 직장도 실명 대신 "AI·IoT 기업 재직 중" 수준으로만 표기합니다. 개인 계정과 회사 계정을 저장소 단위로 분리해 운영합니다.
결과와 한계
1차로 기획한 20편 중 6편을 발행했고, 발행을 이어가고 있습니다. 블로그를 통한 첫 실제 진단 유입은 첫 글 발행 당일인 8월 30일에 확인했습니다. 발행 초기라 누적 유입과 진단 완주율은 아직 유의미한 수준이 아니며, 이 구조의 검증은 90일 뒤 12~15편이 쌓인 시점에 가능합니다. QR을 실제로 찍는 사람이 있는지는 _q 파라미터 집계로 두 달 안에 판별됩니다.
20편은 끝이 아니라 시작점입니다. 정책·제도 글이 검색 유입의 축을 잡으면, 그다음은 제가 직접 만든 AI 자동화·서비스 사례를 콘텐츠로 풀어 전역 준비자와 실무자 양쪽으로 주제를 넓혀 갈 계획입니다. 만든 것이 이미 여덟 건이라 소재는 충분합니다.
화면과 시연
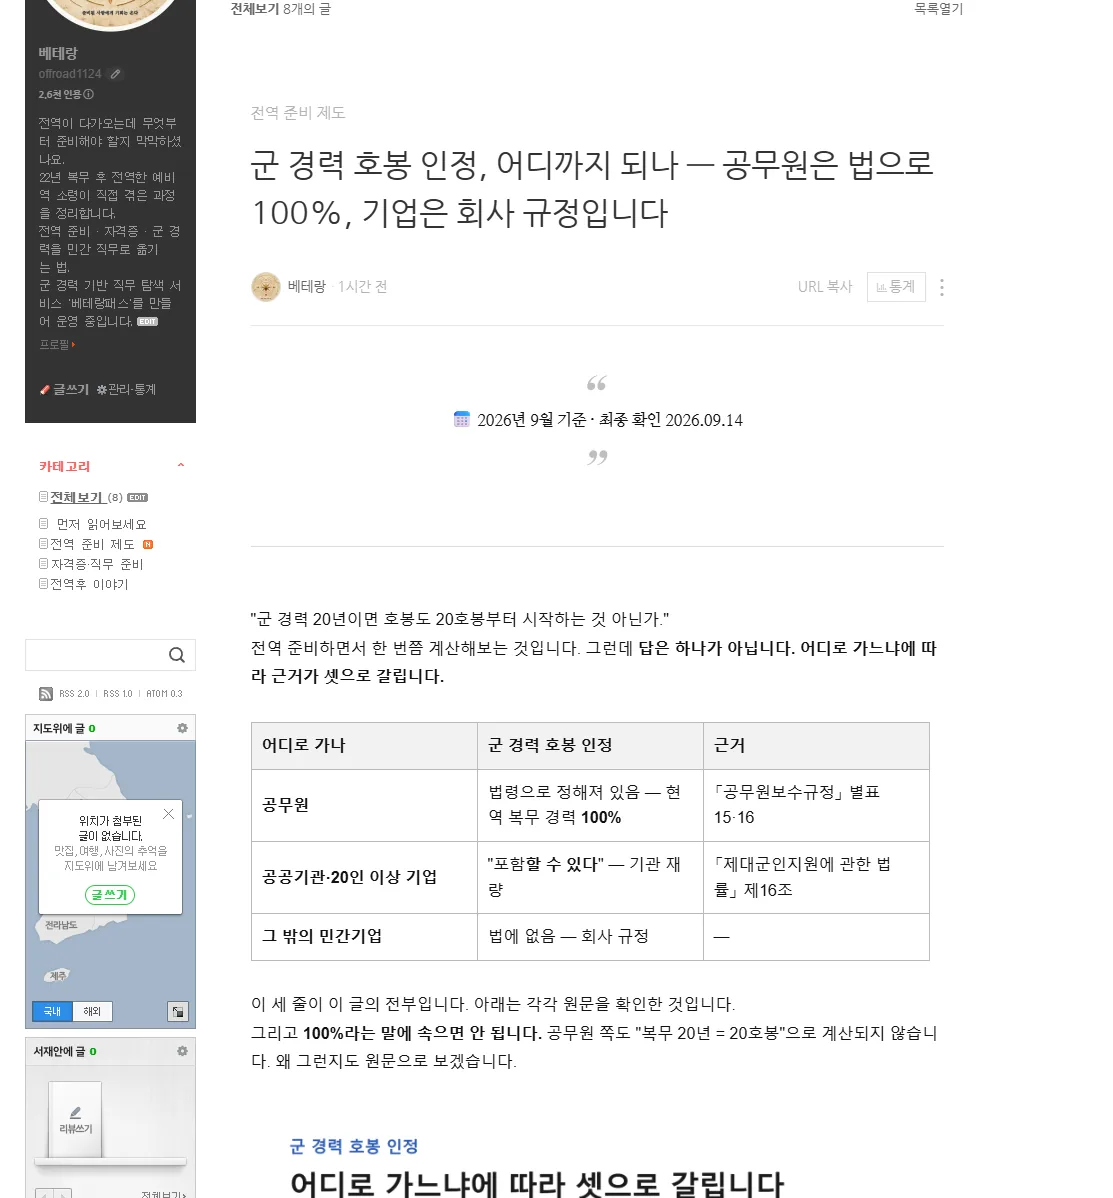
- 스크린샷 — 발행된 글의 기준일 배지와 본문 인라인 출처
- 스크린샷 — 글 하단 CTA 3중 구조(링크·QR·검색 안내)
- 스크린샷 — 인포그래픽 카드와 수치 대조 스크립트 실행 결과
- 스크린샷 — 네이버 블로그 통계 유입 검색어 화면